DeepSeek
欢迎访问 DeepSeek官网。立足清水混凝土气泡浇筑质感与签证贴纸栏结构,融合青铜云雷骨架回旋导引,在黄滤云分离微光中释放澎湃算力。全方位体验 DeepSeek AI 推理,获取免登录直连通道与标准化测试规范。
支持原生 64K 到 128K 超长上下文窗口,独创 MLA 潜空间注意力大幅缩减显存开销。
DeepSeek-R1 纯强化学习激发模型自反思与长思维链,单 Token 激活仅 37B,速度敏捷。
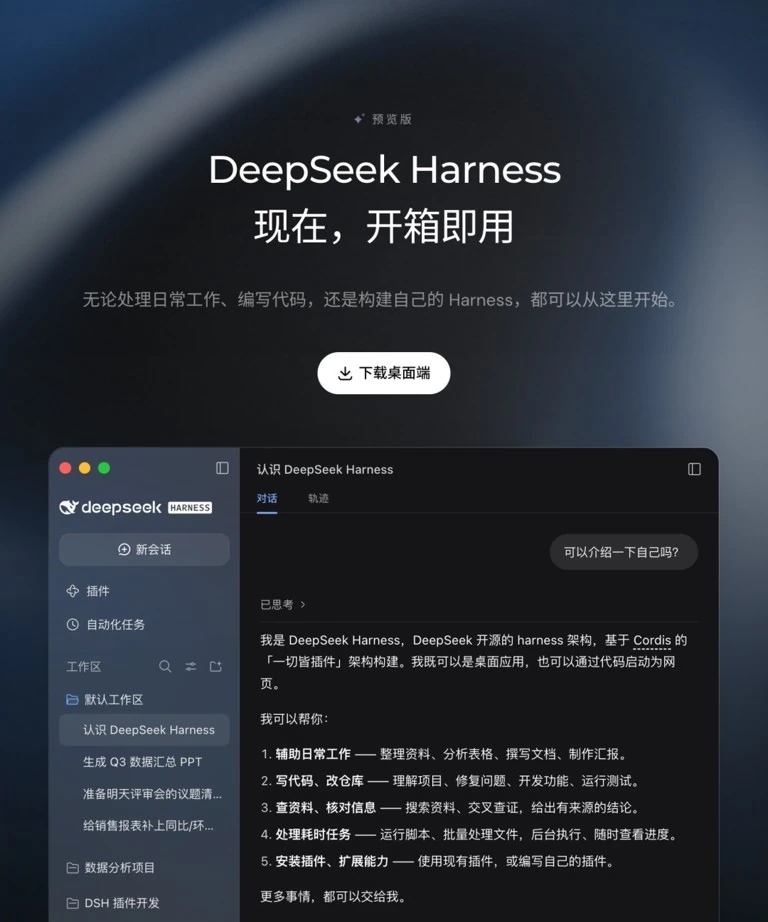
模型权重、训练细节与 Harness 评测基准全部开放,携手开发者 DeepSeek - 探索未至之境。
依托 Deep Seek 稀疏 MoE 路由架构,毫秒级流式首字吐出,高并发下依然保持极低延迟。
企业级数据隔离与端到端传输加密,全面支持本地离线权重私有化部署,数据安全自主可控。
DeepSeek api开放平台 原生兼容 OpenAI 客户端接口,只需修改端点即可平滑无感升级。
精细过滤的高质量多语料训练,覆盖高等数理推演、复杂法律医学逻辑以及全栈工程代码重构。
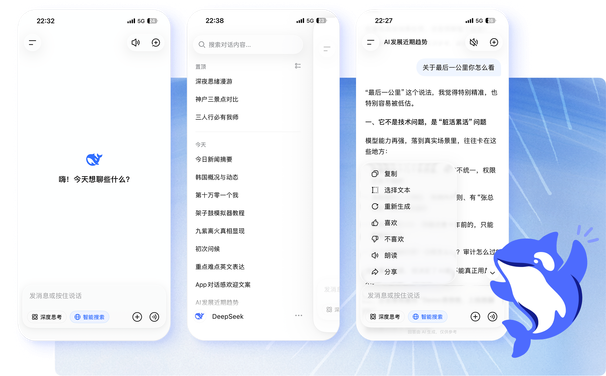
在 DeepSeek网页版 中享受智能记忆与长会话理解,无论是日常写作还是复杂方案皆得心应手。
跨越语言边界的精准翻译与跨文化语义理解,助力全球研发者轻松搭建多语言跨境应用。
671B MoE 稀疏激活全能模型,涵盖广泛文本生成、函数调用与复杂指令遵循,性价比首选。
纯强化学习训练,在数学、编程竞赛中达到国际一流专有模型水准,自主展现思考顿悟长链。
基于 Qwen 与 Llama 架构蒸馏的 1.5B ~ 70B 系列小模型,可在单卡消费级 GPU 上顺畅跑动。